Агенты теряют суть при сжатии контекста: показал тест CompAct-Bench
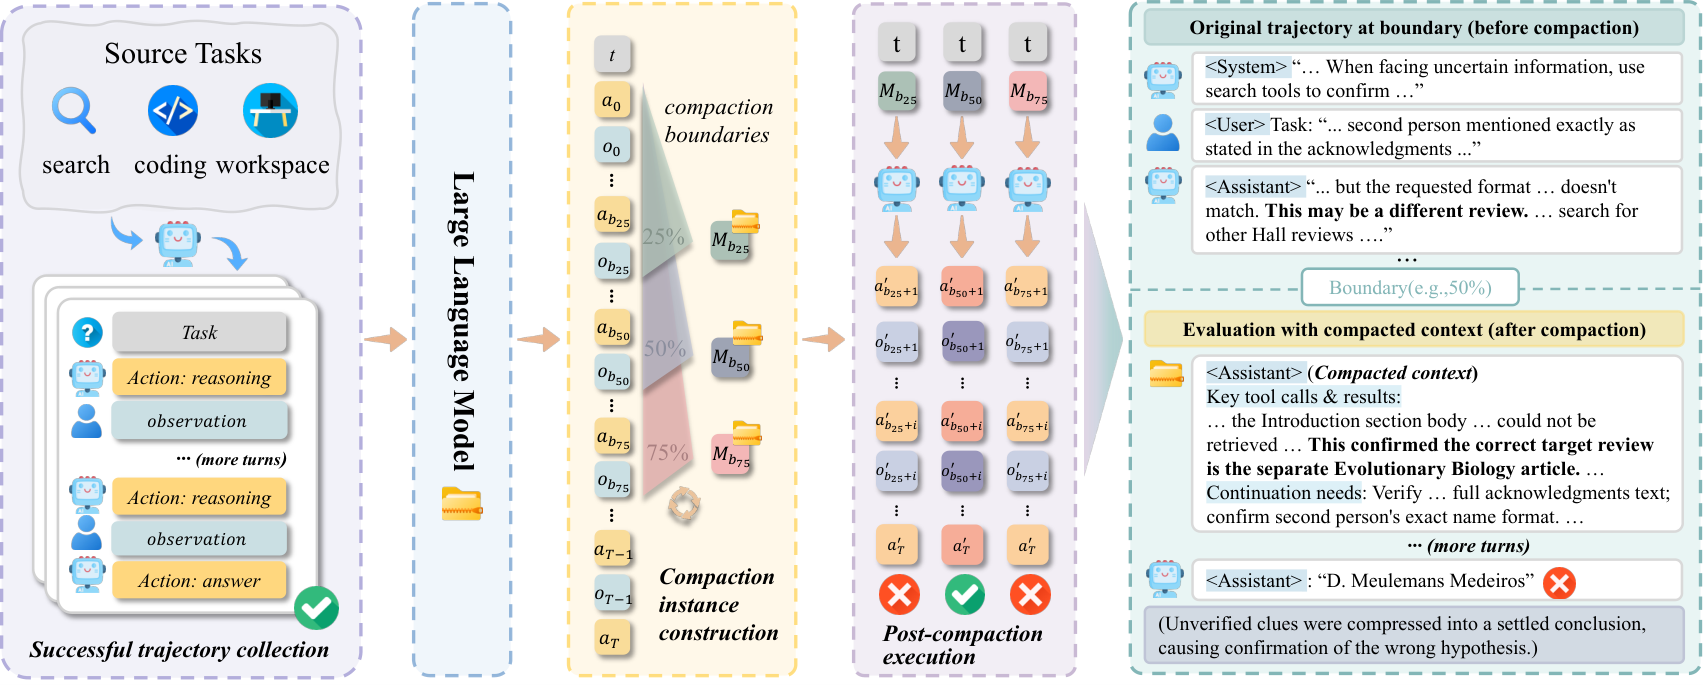
Исследователи представили CompAct-Bench — тест, который проверяет, как нейросети сжимают историю работы ИИ-агента. Согласно статье на arXiv, даже у передовых моделей такое сжатие остаётся процессом с большими потерями.
Чем дольше агент работает над задачей, тем больше записей он копит: шаги, ответы инструментов, промежуточные решения. Если ужать их неточно, агент может принять неверное решение или сделать работу заново.
Коротко
- Тест берёт успешные прогоны агента, в разные моменты сжимает прошлое и даёт тому же исполнителю продолжить задачу.
- Проверка идёт на трёх наборах: BrowseComp, SWE-bench и внутреннем CompanyBench.
- Сбои вызваны не только пропущенными сведениями, но и искажением картины задачи.
Тест оценивает сжатие по тому, чем закончилась задача
Агент здесь — языковая модель, которой поручили долгую задачу из многих шагов. Её рабочий контекст постоянно растёт: в него попадают прошлые действия, ответы инструментов, промежуточные решения и сведения о прогрессе.
Сжатие уменьшает эту историю, чтобы работа могла продолжаться. Авторы берут уже успешные прогоны, в разные моменты вставляют границу сжатия и просят проверяемую модель ужать всё, что было до неё. Затем тот же исполнитель пробует довести исходную задачу до конца.
Чтобы сравнение было честным, модели ставят в одинаковые условия по доле сохранённого. Её подгоняют простой процедурой с повторными поправками. Задачи трёх видов: поиск информации (BrowseComp), программирование (SWE-bench) и работа с рабочим пространством (внутренний CompanyBench).
Лучшие результаты у Claude и GPT, но потери остаются
По словам авторов, модели семейств Claude и GPT показали лучший результат в целом. Но даже у них точность выполнения задач заметно падает, если сжимать контекст агрессивно.
Вывод исследователей: сжатие рабочего контекста — отдельный навык, и он по-прежнему даётся моделям с трудом.
Сбои вызывает и искажение состояния задачи
Разбор ошибок показал: сбои часто связаны не только с выброшенной информацией. Портится и само состояние дел, то есть искажается картина задачи.
Например, нерешённая проблема в пересказе превращается в будто бы готовый вывод. Или модель забывает результат, который уже был получен раньше.
Из-за этого агент может принять неверное решение или выполнить лишнюю работу повторно.
Что это значит для вас
- Сжатие истории — не нейтральная экономия: по данным авторов, оно способно изменить картину задачи.
- Авторы оценивают сжатие по тому, удалось ли агенту завершить задачу, а не по аккуратности пересказа.
- Выводы относятся к тестовым задачам; о конкретных продуктах в аннотации ничего не сказано.
Что делать
Пока ничего: следите за развитием CompAct-Bench и результатами новых моделей.
Чего пока неизвестно
В аннотации нет чисел: неясно, насколько именно падает точность и какие версии моделей проверяли.
Редакция «Применяй ИИ» · Как мы готовим новости