DeepSeek выложила DeepGEMM — библиотеку CUDA-ядер для матричных операций, на которых держатся современные LLM: GEMM в FP8, FP4 и BF16, fused MoE с перекрытием коммуникации (Mega MoE), MQA-скоринг для lightning indexer и
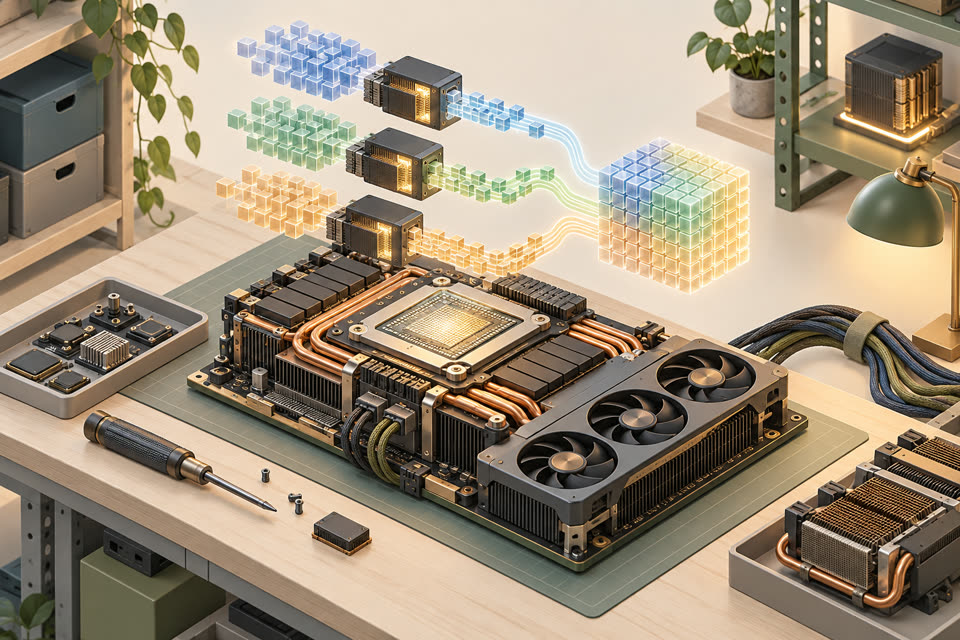
🛠 DeepSeek выложила DeepGEMM — библиотеку CUDA-ядер для матричных операций, на которых держатся современные LLM: GEMM в FP8, FP4 и BF16, fused MoE с перекрытием коммуникации (Mega MoE), MQA-скоринг для lightning indexer и HyperConnection.
⚙️ Все ядра компилируются на лету через DeepJIT, так что при установке ничего собирать под CUDA не нужно. Подключается как обычный Python-модуль `deep_gemm`, ставится скриптом `install.sh`.
📋 Что нужно: GPU NVIDIA архитектуры SM90 или SM100, CUDA Toolkit 12.9+, PyTorch 2.3+ и Python 3.8+. Для Mega MoE — PyTorch от 2.9.
По словам авторов, код сделан простым и подходит, чтобы разобраться в оптимизации ядер под GPU NVIDIA, а скорость не уступает вручную настроенным библиотекам. Лицензия MIT.
Репозиторий по ссылке.
Справка:Досье: DeepSeek
Комментарии
Комментарии ведутся в Telegram: войдите через Telegram, чтобы написать или поставить лайк. Открыть обсуждение