Liquid AI выложила LFM3-Omni-2B: одна модель на 2,17 млрд параметров понимает текст, картинки, видео и аудио, а отвечает текстом или голосом
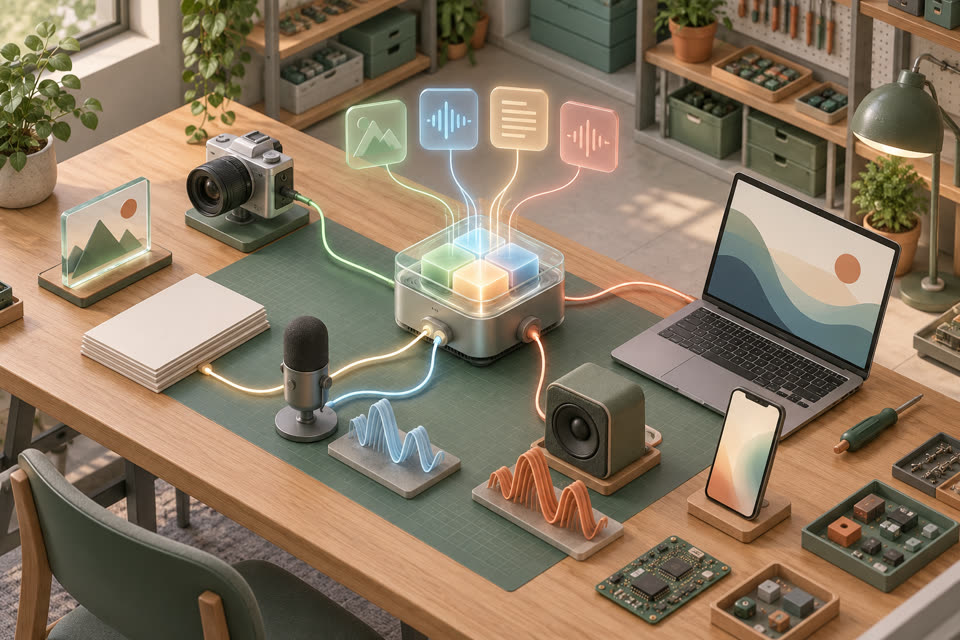
🧠 Liquid AI выложила LFM3-Omni-2B: одна модель на 2,17 млрд параметров понимает текст, картинки, видео и аудио, а отвечает текстом или голосом.
По описанию компании, она заменяет сразу четыре отдельные модели: распознавание речи, зрение, LLM и синтез голоса. Видео со звуком модель одновременно смотрит и слушает, так что можно спросить про картинку и звук вместе. Заточена под телефоны, ноутбуки и прочее железо на месте, без облака.
🛠 Запуск: через Transformers (версия 5.20.2 и новее, нужен `trust_remote_code`) или SGLang, но он отдаёт только текст. Для локального запуска на CPU и GPU есть GGUF-версия для llama.cpp с сервером реалтайм-речи.
🌍 Речь на входе и выходе: 19 языков и локалей, включая китайский, немецкий и японский. Текст понимает 16 языков, русский среди них. Для речи русского в списке нет.
⚖️ Контекст 32K токенов, лицензия LFM Open License v1.0. Модель без режима рассуждений.
Забираем по ссылке.
Темы:Деньги и рынок
Комментарии
Комментарии ведутся в Telegram: войдите через Telegram, чтобы написать или поставить лайк. Открыть обсуждение