QL-VLM сжимает ИИ для картинок до 4 бит и ускоряет ответы в 6,4 раза
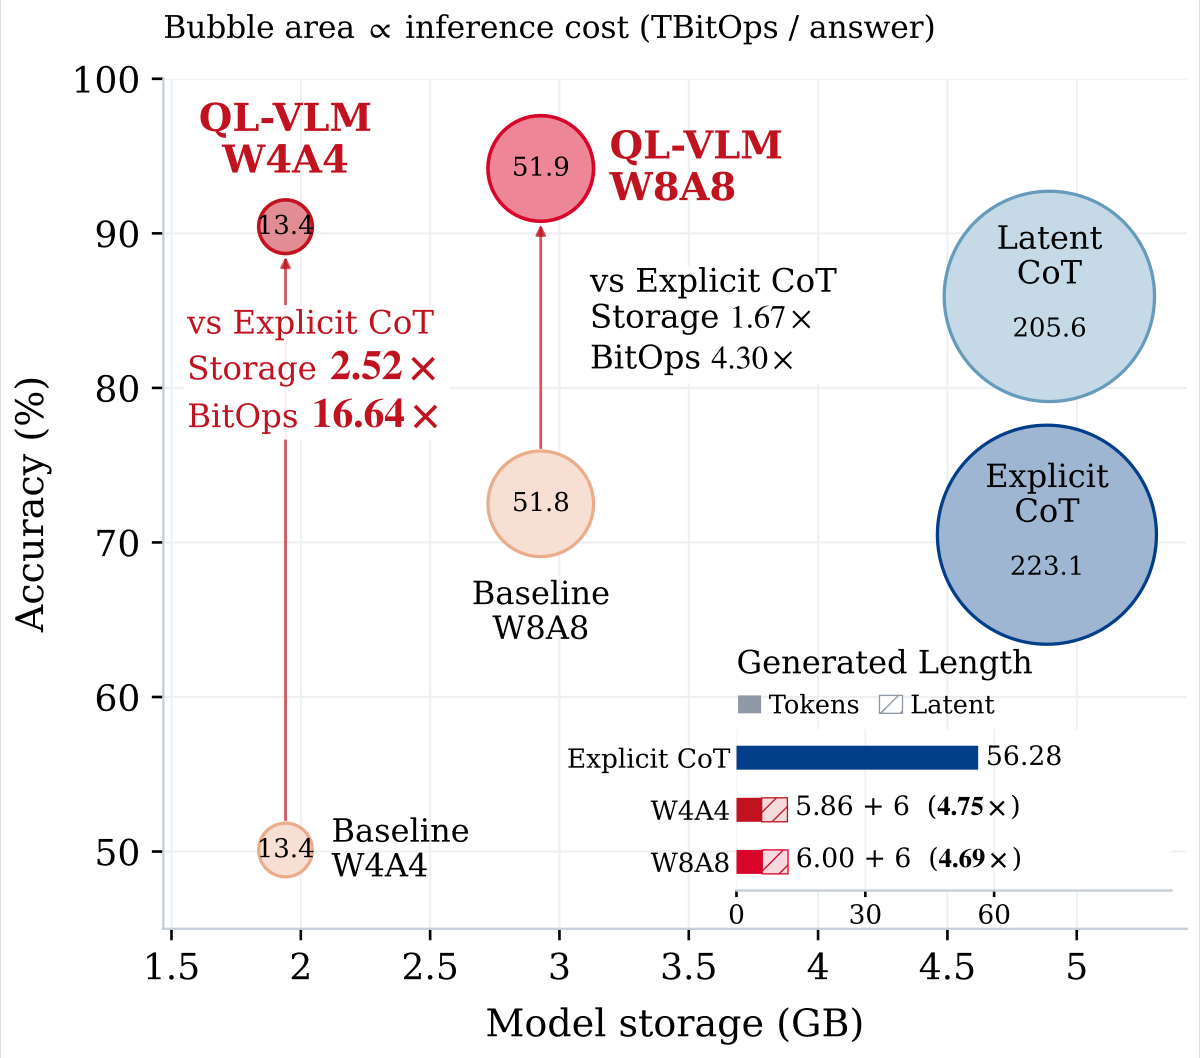
Авторы препринта на arXiv представили метод QL-VLM: он сжимает до 4 бит модели, которые работают с картинками и текстом. На тесте ScienceQA-IMG с Qwen2-VL-2B-Instruct точность составила 90,43%.
Чем меньше памяти и вычислений нужно модели, тем проще её запускать. Но это научная работа: в аннотации один тест, о продуктах и ценах там нет ни слова.
Коротко
- Метод состоит из двух частей: особого способа округлять числа и дообучения по образцу полноточной версии модели.
- Улучшение к базовому подходу составило 40,33%, но аннотация не называет, что взято за базу.
- Результат приведён для одной модели на одном тесте.
Прямое сжатие до 4 бит сильно портит рассуждения
Часть методов заменяет текстовые пояснения модели «непрерывными мыслями»: внутренними числовыми представлениями шагов. Шагов становится меньше, но такие модели в полной точности по-прежнему занимают много места.
Снизить точность чисел можно квантованием. По словам авторов, прямое квантование сильно ухудшает рассуждения, особенно когда 4 бита отводят и весам модели, и активациям, то есть промежуточным результатам расчётов.
Два приёма берегут поиск сведений и ход рассуждения
Анализ авторов показал: мало точно воспроизвести числа. Важно сохранить поиск нужной информации и последующие шаги рассуждения.
Приём DGQ округляет числа по специально составленным наборам значений, а не с равным шагом. Так сжатие меньше искажает поиск сведений в картинке и тексте.
Приём DPD дообучает сжатую модель с помощью полноточной версии-учителя. Промежуточные шаги и ответы сжатой модели подгоняют под ответы учителя.
Вычислений в 16,64 раза меньше, задержка ниже в 6,40 раза
Явная цепочка рассуждений означает, что модель выписывает шаги текстом. По сравнению с ней 4-битный QL-VLM требует в 16,64 раза меньше битовых операций, а измеренная задержка ниже в 6,40 раза.
Что это значит для вас
- Это исследовательская работа, а не продукт: готовых сервисов, цен и сроков в аннотации нет.
- Авторы показывают, что сжатие до 4 бит можно сочетать с рассуждениями по картинкам. Подтверждено это для одной модели на одном тесте.
Что делать
Пока ничего: в аннотации описан результат на ScienceQA-IMG с Qwen2-VL-2B-Instruct, сведений о готовых инструментах в ней нет.
Чего пока неизвестно
Аннотация не называет базовый подход, с которым сравнивали улучшение в 40,33%. Точности полноточной модели в ней тоже нет.
Редакция «Применяй ИИ» · Как мы готовим новости